
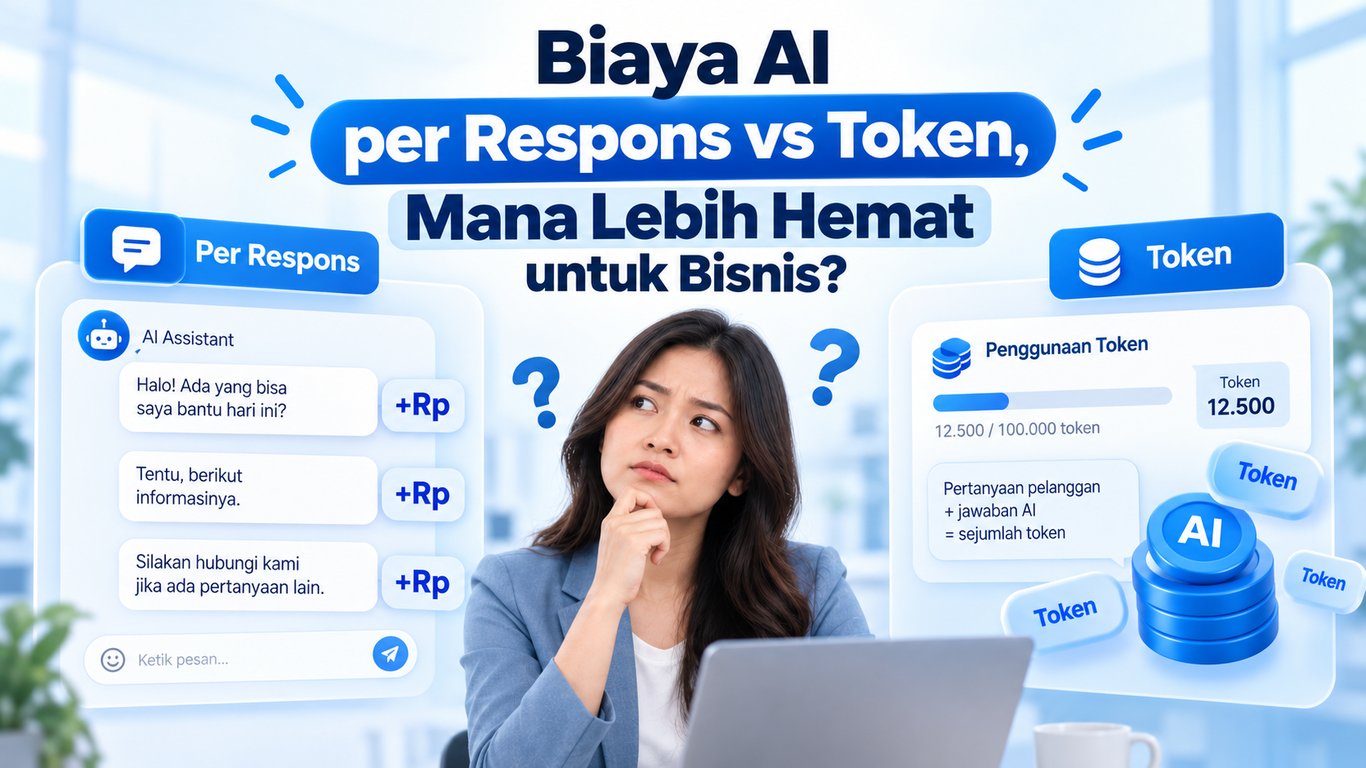
Biaya AI per Respons vs Token, Mana Lebih Hemat untuk Bisnis?
Barantum adalah solusi aplikasi all in one CRM terbaik untuk bisnis yang menyediakan WhatsApp CRM, broadcast, chatbot, AI Agent, omnichannel, dan call center dalam satu platform terintegrasi. Kelola dan optimalkan seluruh perjalanan customer, mulai dari customer masuk, closing, dan repeat order.
Dua proposal AI Agent dapat terlihat sama-sama murah, tetapi sebenarnya memakai satuan berbeda. Penyedia pertama mengenakan biaya per respons. Penyedia kedua menghitung token input dan output. Tanpa menyamakan asumsi, angka tersebut tidak dapat dibandingkan secara adil.
Bisnis perlu memahami apa yang memengaruhi setiap unit, lalu menambahkan biaya kanal dan kebutuhan operasional. Model yang paling hemat bukan hanya yang memiliki tarif awal terendah, tetapi yang paling sesuai dengan volume, panjang jawaban, dan kompleksitas layanan.
Pahami Satuan yang Sebenarnya Dibayar
Pada model per respons, bisnis membayar setiap jawaban AI yang dikirim. Struktur ini lebih mudah diproyeksikan: jumlah respons dikalikan tarif. Namun, definisi respons perlu dibaca dengan jelas karena jawaban yang lebih panjang dapat memiliki biaya berbeda.
Pada model token, biaya dihitung dari potongan teks yang diproses AI. Token mencakup konteks percakapan, instruksi sistem, dokumen knowledge base yang dipanggil, dan output. Semakin panjang konteks serta jawaban, semakin besar pemakaian token.
Karena itu, dua chatbot dengan jumlah pesan sama belum tentu memakai token sama. Use case FAQ singkat berbeda dengan troubleshooting yang membaca histori panjang atau menghasilkan penjelasan bertahap.
Tanyakan apakah riwayat lengkap selalu dikirim ulang, apakah sistem merangkum konteks, dan bagaimana dokumen dipilih sebelum jawaban dibuat. Cara tersebut memengaruhi token jauh lebih besar daripada jumlah file knowledge base semata.
Buat Simulasi dengan Asumsi yang Sama
Rumus model per respons adalah volume respons dikalikan tarif per respons. Rumus token adalah total token input dan output dibagi satu juta, kemudian dikalikan tarif per satu juta token.
Dalam ilustrasi campaign ini, tarif US$2 per satu juta token dan penggunaan sekitar 20–25 ribu token per respons menghasilkan kira-kira 40–50 respons. Contoh tersebut tidak dikonversi ke rupiah karena kurs dapat berubah.
Perbandingan harus memakai pertanyaan, panjang knowledge base, kualitas jawaban, dan tingkat eskalasi yang sama. Lakukan simulasi ringan, normal, dan berat agar perusahaan melihat seberapa sensitif biaya terhadap konteks panjang.
Tambahkan skenario kenaikan traffic 20–30 persen dan respons yang lebih panjang. Model yang stabil pada demo dapat menjadi sulit diprediksi ketika histori percakapan bertambah atau pertanyaan membutuhkan beberapa dokumen sekaligus.
Sebagai contoh model per respons, AI Agent Barantum menggunakan harga mulai Rp150 per respons. Jika bisnis memperkirakan 10.000 respons, simulasi awal memakai 10.000 dikalikan tarif yang berlaku, lalu disesuaikan dengan panjang respons dan kebutuhan implementasi. Contoh ini tidak otomatis menjadikannya paling murah.
Hitung Total Cost, Bukan Tarif AI Saja
Respons yang dikirim melalui WhatsApp Business API Barantum tetap perlu memperhitungkan service message WhatsApp. Karena itu, total biaya pada kanal tersebut adalah biaya AI ditambah biaya pesan yang berlaku.
Selanjutnya, masukkan biaya handoff manusia, jumlah kanal, pengelolaan knowledge base, routing, laporan, serta integrasi data. AI yang sedikit lebih mahal per unit dapat memberi total cost lebih baik jika mengurangi alat terpisah dan menjaga histori pelanggan.
Masukkan pula waktu review jawaban, maintenance konten, pelatihan agent, dan kebutuhan audit. Komponen tersebut tidak selalu muncul sebagai biaya pemakaian AI, tetapi memengaruhi total cost of ownership sepanjang kontrak.
Saat menilai proposal, minta definisi respons, aturan pembulatan token, biaya model, batas knowledge base, channel yang termasuk, mekanisme handoff, dan format laporan. Jika data layanan terhubung dengan CRM Barantum, biaya dapat dianalisis bersama histori pelanggan, tahap pipeline, dan outcome per use case.
Keputusan akhir sebaiknya memakai volume aktual dan uji coba terukur. Per-respons unggul dalam kemudahan proyeksi, sedangkan token memberi rincian pemakaian yang granular. Mana yang lebih hemat tetap bergantung pada cara AI digunakan dan seluruh biaya yang menyertainya.
Lakukan pilot dengan daftar pertanyaan dan volume yang sama, kemudian bandingkan biaya per percakapan selesai, bukan hanya biaya per respons. Ukuran ini menghindari kesimpulan keliru ketika satu model menghasilkan respons murah tetapi lebih banyak percakapan ulang.
Artikel ini juga tayang di vritimes

Pos terkait


